Rekasator
Trouver une sélection de développements
Conservez au moins deux développements par leçon avec une sélection aussi petite que possible. Votre fichier reste dans votre navigateur ; aucun calcul n’est envoyé au serveur.
Préparer le fichier et lire les résultats
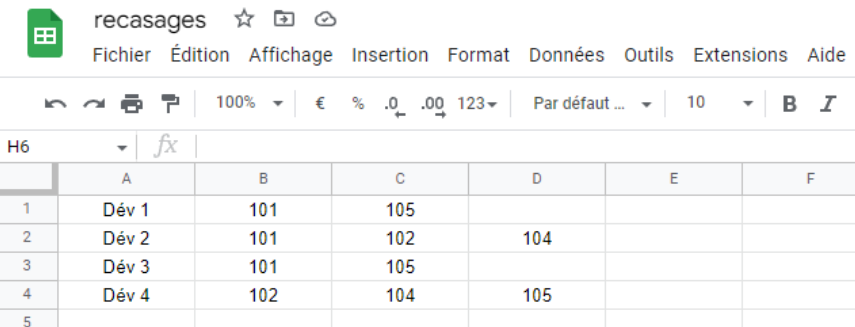
- Répertoriez vos développements dans un tableur : un nom par ligne dans la première colonne, puis les numéros des leçons dans les colonnes suivantes.
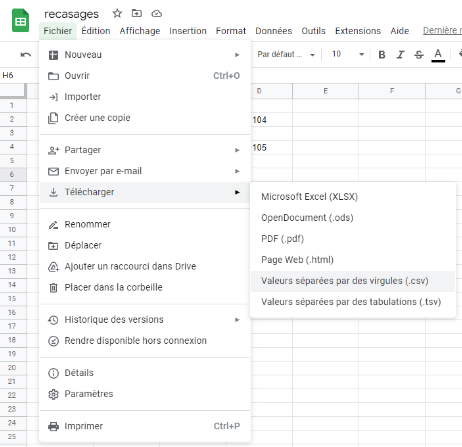
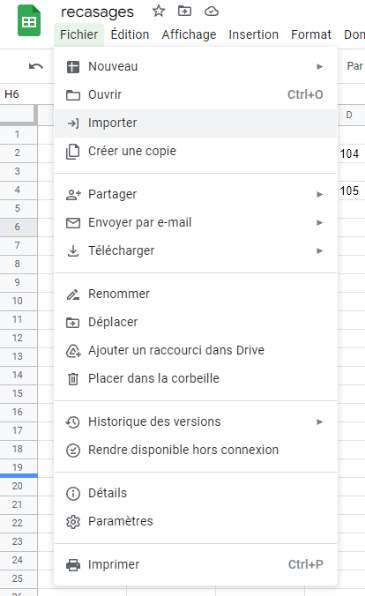
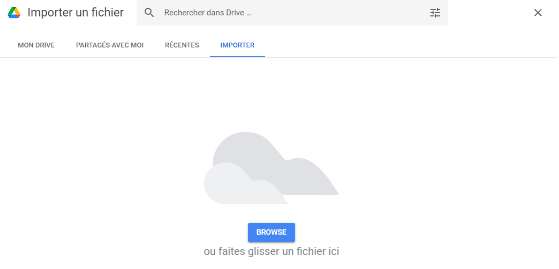
- Exportez au format CSV UTF-8 et importez ce fichier dans l’outil ci-dessus. Une ligne d’en-tête est facultative ; les lignes entièrement vides sont ignorées.
- Vérifiez la liste des leçons à couvrir. Les listes du script original correspondent à 2023 : adaptez-les si nécessaire.
- Choisissez le nombre minimal et maximal de développements à conserver. La recherche teste les tailles croissantes et s’arrête dès qu’elle trouve des sélections valides.
- Dépliez une sélection ou téléchargez les résultats. Chaque sélection assure au moins deux développements par leçon demandée. Si vous atteignez votre borne minimale, vous pouvez relancer avec une plage plus basse.
Le calcul de la version navigateur est une adaptation en JavaScript de la recherche Python. Il s’exécute en arrière-plan sur votre appareil : vous pouvez continuer à utiliser la page et arrêter la recherche à tout moment. Le serveur fournit simplement les fichiers de l’application.
Voir les illustrations du format tableur
Le script Python
Vous pouvez aussi utiliser le script de l’ancien site sur votre ordinateur. Son indentation et sa barre de progression ont été corrigées. Contrairement à la version navigateur, il conserve les solutions pour toutes les tailles valides de la plage testée.
Afficher le code Python
import csv

try: # Barres de progression si les modules sont installés
  from tqdm import tqdm
  from scipy.special import binom
  progression = True
except:
  progression = False

def devs_par_lecon(recasages: dict, lecons: list) -> dict:
  """ Renvoie, pour chaque leçon, la liste des développements qui s'y recasent.
    Autrement dit, inverse le dictionnaire 'recasages'.
    Entrées:
        - recasages (dict): format {"nom développement": {liste recasages}}
        - lecons (list): liste de numéros de leçons
    Sortie:
        - (dict): format {numéro de leçon: ["nom développement"]}
  """
  # Initialisation de la valriable retour
  parLecon = {}
  for lecon in lecons:
      parLecon[lecon] = []
  # Vérification des recasages
  for dev, listeLecons in recasages.items():
      for lecon in listeLecons:
          if lecon in lecons and dev not in parLecon[lecon]:
              parLecon[lecon].append(dev)
  return parLecon

def nb_devs_par_lecon(recasages: dict, lecons: list) -> dict:
  """ Renvoie le nombre de lecons recasées par lecons. """
  devsParLecon = devs_par_lecon(recasages, lecons)
  nbParLecon = {lecon: len(devs) for lecon, devs in devsParLecon.items()}
  return nbParLecon

def dict_moins_1_cle(D):
  cles = list(D.keys())
  return {k: D[k] for k in cles[1:]}, cles[0]

def extraire_sous_dict_taille_donnee(D, n):
  """ Générateur des sous-dictionnaires de taille n de D """
  if n == 0:
      yield {}
  elif len(D) > n:
      Dm1c, c = dict_moins_1_cle(D)
      for subcombi in extraire_sous_dict_taille_donnee(Dm1c, n-1):
          subcombi[c] = D[c]
          yield subcombi
      for combi in extraire_sous_dict_taille_donnee(Dm1c, n):
          yield combi
  else:
      yield D

# Liste des leçons: si vous voulez tester sur une partie des leçons uniquement, remplacez les listes
# suivantes par les listes des leçons correspondantes
algebre = [101, 102, 103, 104, 105, 106, 108, 120, 121, 122, 123, 125, 126, 141, 142, 144, 148, 149, 151, 152, 153, 154, 155,
        156, 157, 158, 159, 160, 161, 162, 170, 171, 181, 190, 191]
analyse = [201, 203, 204, 205, 206, 208, 209, 213, 214, 215, 219, 220, 221, 223, 224, 226, 228, 229, 230, 234, 235, 236, 239,
        241, 243, 245, 246, 250, 253, 261, 262, 264, 265, 266, 267]

recasagesImportes = {}
with open('recasages.csv', mode='r', encoding='utf-8') as flux:
  entree = csv.reader(flux)
  for ligne in entree:
      rec = list(filter(('').__ne__, ligne))
      recasagesImportes[rec[0]] = list(map(int, rec[1:]))

print(f"Importation réussie ({len(recasagesImportes)} développements) !\n")
# NOTE: C'est long. Vraiment. Il risque d'y avoir des saturations de mémoire: il est donc conseillé de
# faire tourner l'algorithme plusieurs fois, pour plusieurs plages de valeurs.
print(" REKASATOR (tm) ".center(60, '#'))
print("\nSélectionnez le type de test:")
aTester = input("Tout tester: 0\nAlgèbre uniquement: 1\nAnalyse uniquement: 2\n>>> ")

if aTester != "0":
  recasages = {}
  for dev, recs in recasagesImportes.items():
      recs.sort()
      i = len(recs) - 1
      while i >= 0 and int(recs[i]) >= 200:
          i -= 1
      if aTester == "1" and i == len(recs) - 1:
          recasages[dev] = recs
      elif aTester == "2" and i == -1:
          recasages[dev] = recs
      elif i >= 0 and i < len(recs) - 1:
          recasages[dev] = recs
  if aTester == "1":
      lecons = algebre
  elif aTester == "2":
      lecons = analyse
  else:
      lecons = algebre + analyse
else:
  recasages = recasagesImportes
  lecons = algebre + analyse


N = len(recasages)
print(f"({N} recasages correspondants.)\n")

print("/!\\ NOTE: aucun document ne sera produit si le programme ne termine pas correctement. " +
  "En raison du volume de données, privilégiez des plages de test de faible amplitude, " +
  "quitte à faire tourner le programme plusieurs fois.")
inf = int(input("Nb min de développements à tester >>> "))
sup = int(input("Nb max de développements à tester >>> "))

optimisationsPossibles = []
stop = False
n = min(sup, N)
while not stop and n >= inf: # On explore toutes les possibilités
  print(f">>> Test: {n} développements...")
  extraction = extraire_sous_dict_taille_donnee(recasages, n)
  stop = True
  if progression:
      t = tqdm(total=binom(N,n))
      prog = 0
  for extrait in extraction:
      nbDevsParLecon = list(nb_devs_par_lecon(extrait, lecons).values())
      i = 0
      ok = True
      while i < len(nbDevsParLecon) and ok: # On teste si toutes les leçons ont au moins 2 développements
          ok = nbDevsParLecon[i] >= 2
          i += 1
      if ok: # Si c'est bien le cas, on enregistre le résultat
          optimisationsPossibles.append(list(set(recasages.keys()) - set(extrait.keys())))
          stop = False
      if progression:
          prog += 1
          t.update(1)
  if progression: t.close()
  n -= 1
optimisationsPossibles.reverse()

with open('optimisations.csv', mode='w', encoding="utf-8", newline='') as flux:
  sortie = csv.writer(flux, delimiter=',')
  for opti in optimisationsPossibles:
      sortie.writerow(opti)

print("Fin de la recherche !", end=" ")
if stop:
  print(f"(Pas de possibilités à moins de {n+1} développements)")
else:
  print("(Il est conseillé de relancer le programme avec un borne inférieure plus petite.)")
Utiliser le script sur son ordinateur
- Installez Python si nécessaire et placez le script et votre fichier
recasages.csvdans le même dossier. - Pour ce script, utilisez un CSV à virgules, sans en-tête ni lignes vides.
- Depuis un terminal ouvert dans ce dossier, lancez
python rekasator.py(oupython3 rekasator.py). - Choisissez algèbre, analyse ou les deux, puis les bornes de la recherche.
- À la fin du calcul, ouvrez
optimisations.csv: chaque ligne indique les développements qui peuvent être retirés ensemble.
Le module csv est inclus dans Python. Pour la barre de progression facultative, installez tqdm et scipy. Sans eux, le script fonctionne également.
La recherche peut être longue et produire beaucoup de résultats. Testez d’abord une plage étroite ; vous pouvez aussi séparer algèbre et analyse, ou modifier les listes de leçons en début de script pour un oral blanc.